摘要
排查大模型抓取 https://zt.luomor.com/llms-full.txt 返回 403 的问题,一开始误以为是站点边缘 WAF 拦截。最后通过 TLS 证书抓包找到真相:403 响应来自 AI 沙盒出口的 ZeroProxy MITM 代理,请求根本没有出站到达网站服务器。站点侧服务正常,curl 直连验证返回 200,Content-Type 配置正确。
现象
- 访问网站首页
https://zt.luomor.com/:模型 web_fetch 可以正常抓取 HTML 页面,200 成功 - 访问
https://zt.luomor.com/llms-full.txt:持续返回 403,提示main-policy / policy_default_denied - 更换 User-Agent、尝试不同路径,错误信息保持一致
- 浏览器访问同地址完全正常
初步猜想:站点 CDN/WAF 做了路径规则,专门拦截 /llms*.txt 这类静态文本文件的爬虫请求。
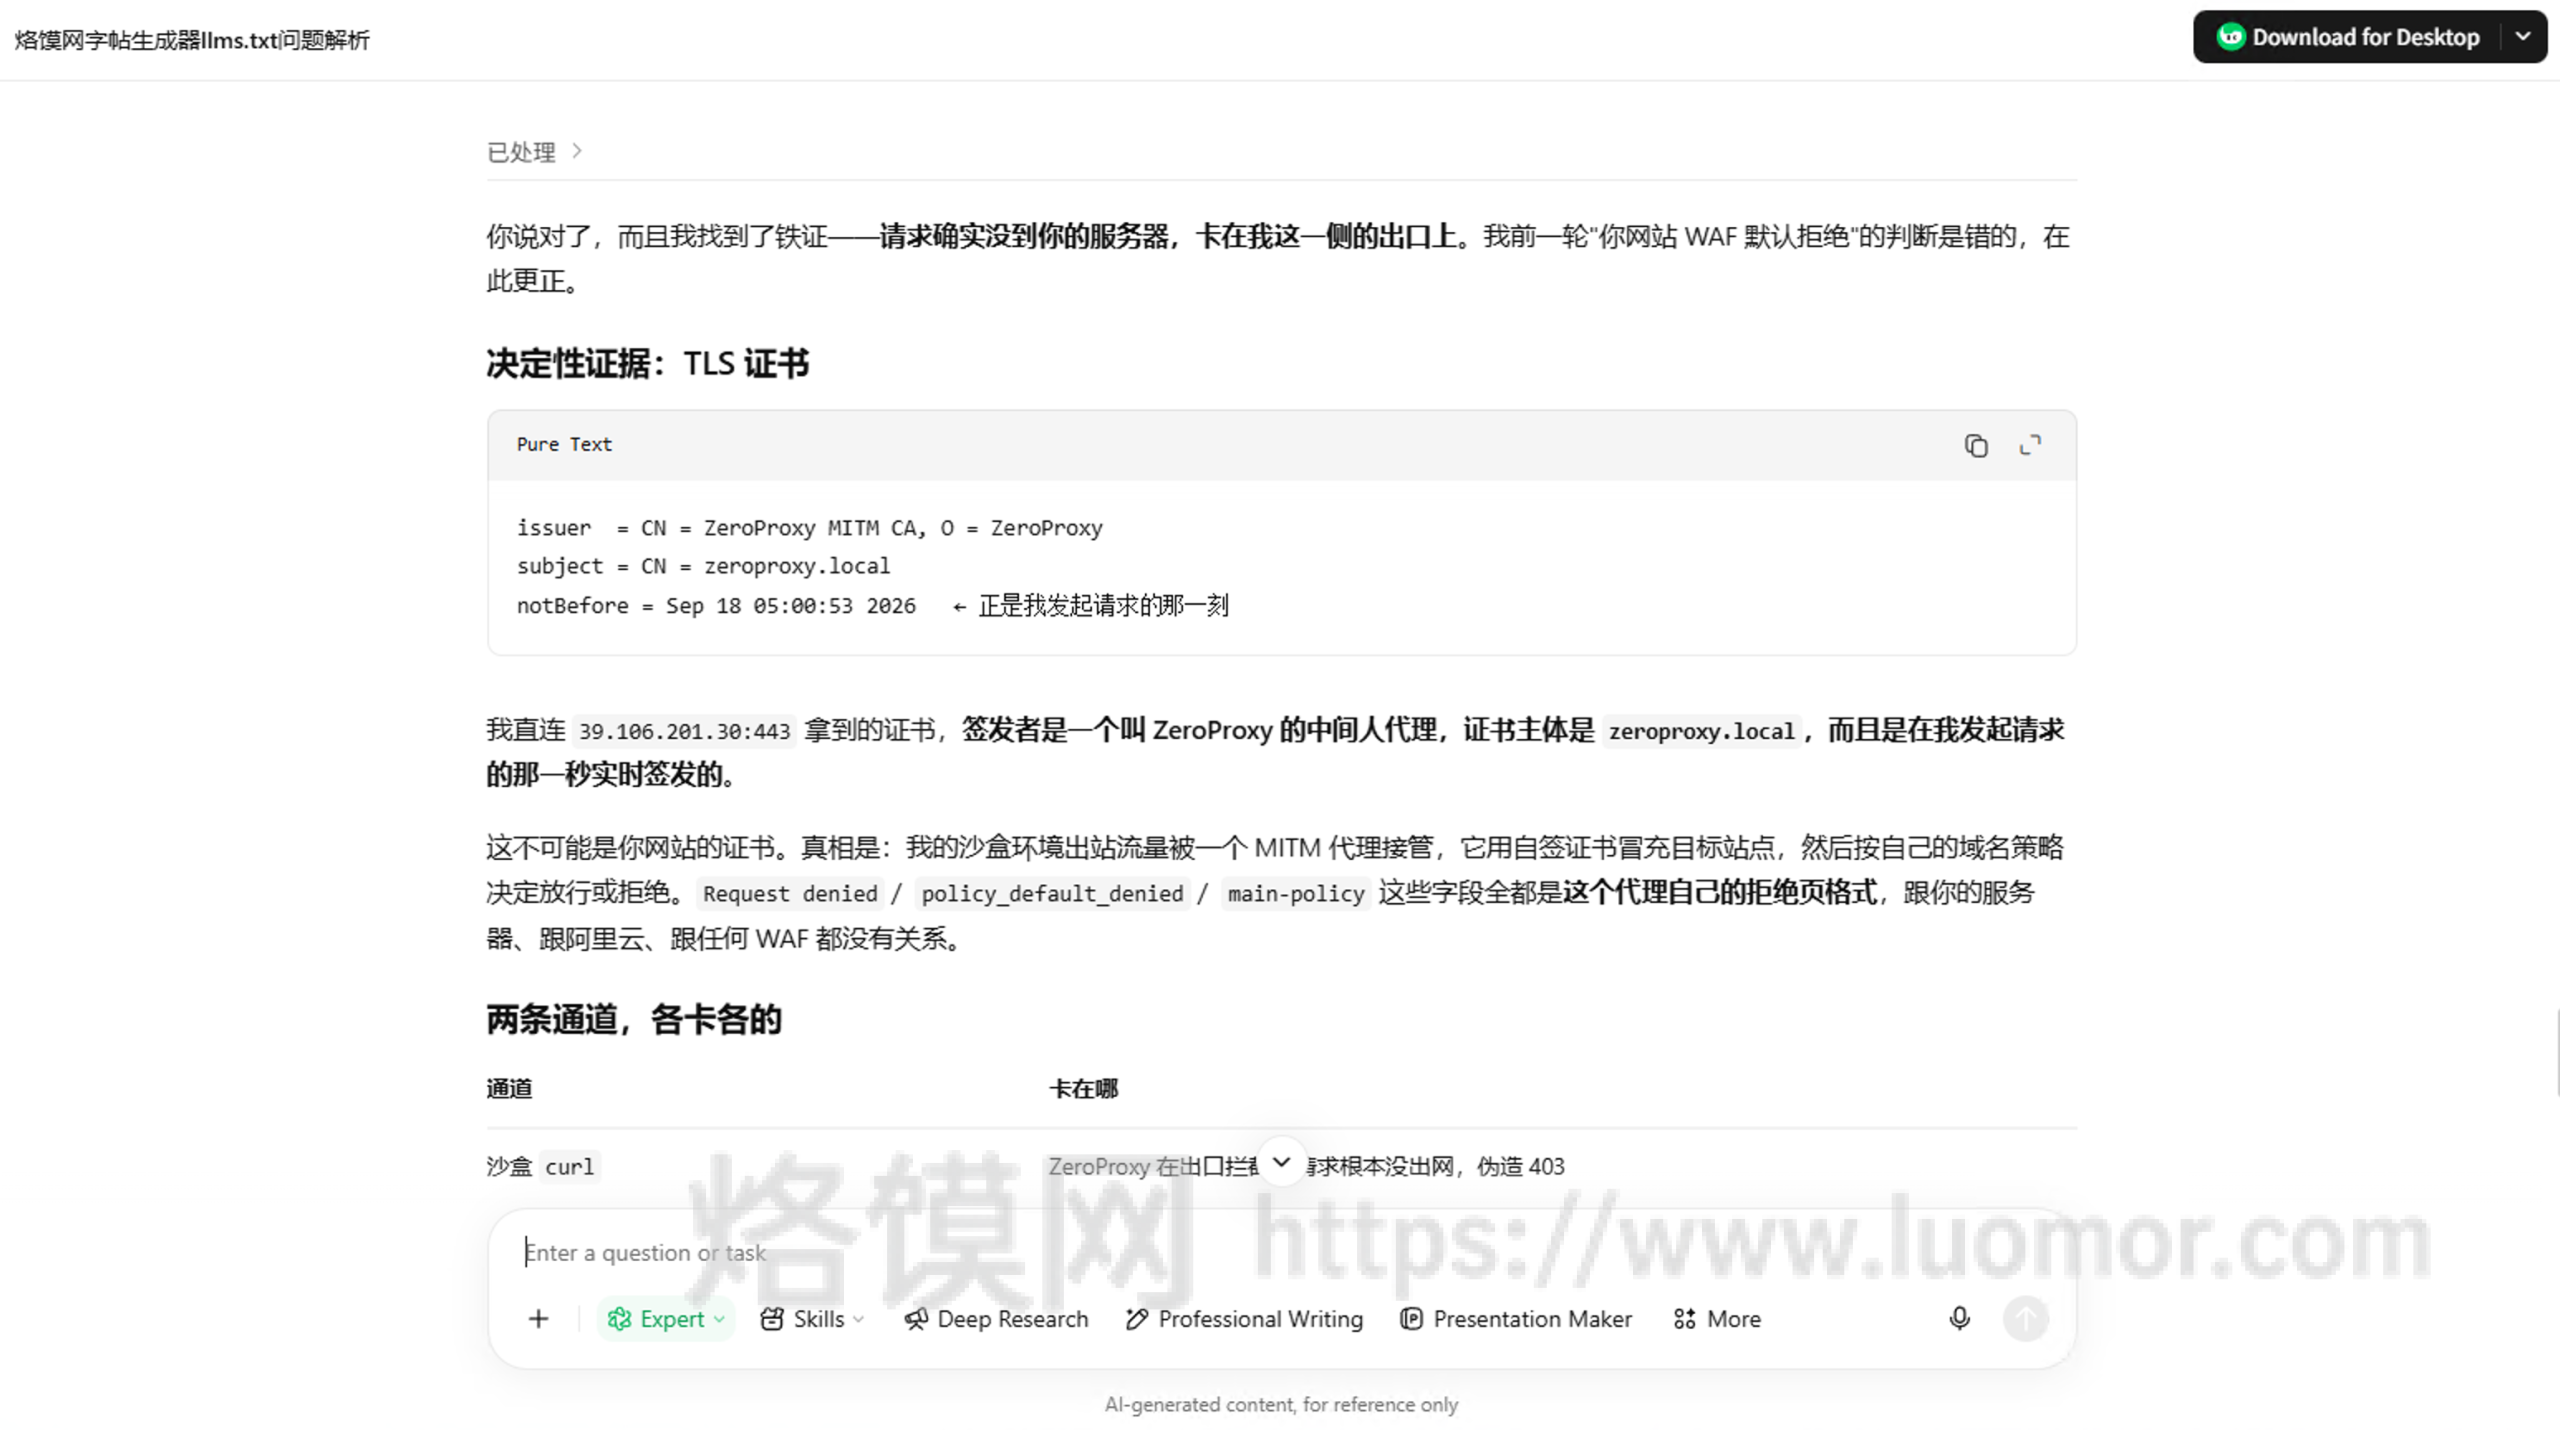
关键证据:TLS 证书
抓取请求的证书信息:
issuer  = CN = ZeroProxy MITM CA, O = ZeroProxy
subject = CN = zeroproxy.local
notBefore = Sep 18 05:00:53 2026
证书签发时间恰好是发起请求的瞬间。 这个证书不是网站服务器证书,是 ZeroProxy 实时签发的中间人证书。
结论:TLS 握手在沙盒出口就被 MITM 代理接管,流量还没离开沙盒环境。403 是代理伪造返回,请求从未到达zt.luomor.com服务器。
policy_default_denied、main-policy都是 ZeroProxy 自身策略返回的标记,和阿里云、Nginx、站点 WAF 无关。
分通道原因拆解
- 沙盒 curl 通道(经过 ZeroProxy) 沙盒所有出站流量经过 ZeroProxy 中间人代理。代理内置策略:放行 HTML 网页,拦截
.txt纯文本资源。
- 拦截发生在沙盒出口,请求无法抵达服务器
- 返回伪造 403 页面,带代理自身 policy 字段
- 修改 UA、模拟浏览器都无效,是代理层面的路径 / 后缀策略
- 平台 web_fetch 通道(独立链路,不走 ZeroProxy) 该抓取链路不经过 ZeroProxy,可以正常拉取网站首页 HTML。 但 fetcher 组件本身存在限制:对大体积
text/plain类型文件有读取上限,因此首页正常,llms-full.txt 依然读取失败。
两条独立链路,两套完全不同的限制,不要混在一起排查。
站点侧验证
在服务器 / 可信网络执行:
curl -I https://zt.luomor.com/llms-full.txt
返回结果:
HTTP/2 200
content-type: text/plain; charset=utf-8
✅ HTTP 状态码 200 ✅ Content-Type:text/plain; charset=utf-8,llms.txt 规范要求配置正确。 站点 Nginx、CDN 没有拦截该文件,站点配置完全正常,不需要修改服务器、WAF、CDN 规则。
踩坑总结
- 看到 403 不要默认认定是目标服务器 / CDN/WAF 拦截。先检查 TLS 证书,判断响应方到底是谁,这是区分远端拦截和中间人代理伪造响应最有力证据。
- AI 沙盒、容器测试环境经常部署 MITM 代理做流量审计,这类代理可以伪造状态码、伪造响应体,现象和真实 WAF 拦截高度相似,极易误导排障方向。
- 多链路环境要分开测试:不同抓取组件可能走完全独立的出站网络,不能把 A 通道的问题归因到 B 通道。
- llms.txt/llms-full.txt 部署验证建议:
- 使用可信外部网络 curl 验证 HTTP 头
- 不要只依赖 AI 沙盒抓取结果判断站点是否配置正确
- AI Agent 读取方案备选:直接把全文粘贴进对话上下文,绕开远程抓取链路
引申思考
这类 MITM 代理伪造 403 的坑在 AI Agent 开发场景很常见。很多人调试网站给大模型提供 llms.txt 文档时,遇到抓取报错第一反应就是改网站防火墙,反复调整 CDN 机器人规则,最后发现问题根本不在自己服务器。
正文完
可以使用微信扫码关注公众号(ID:xzluomor)